Grok 4.7: come si confronta con GPT, Claude e Gemini
Grok 4.7: come si confronta con GPT, Claude e Gemini
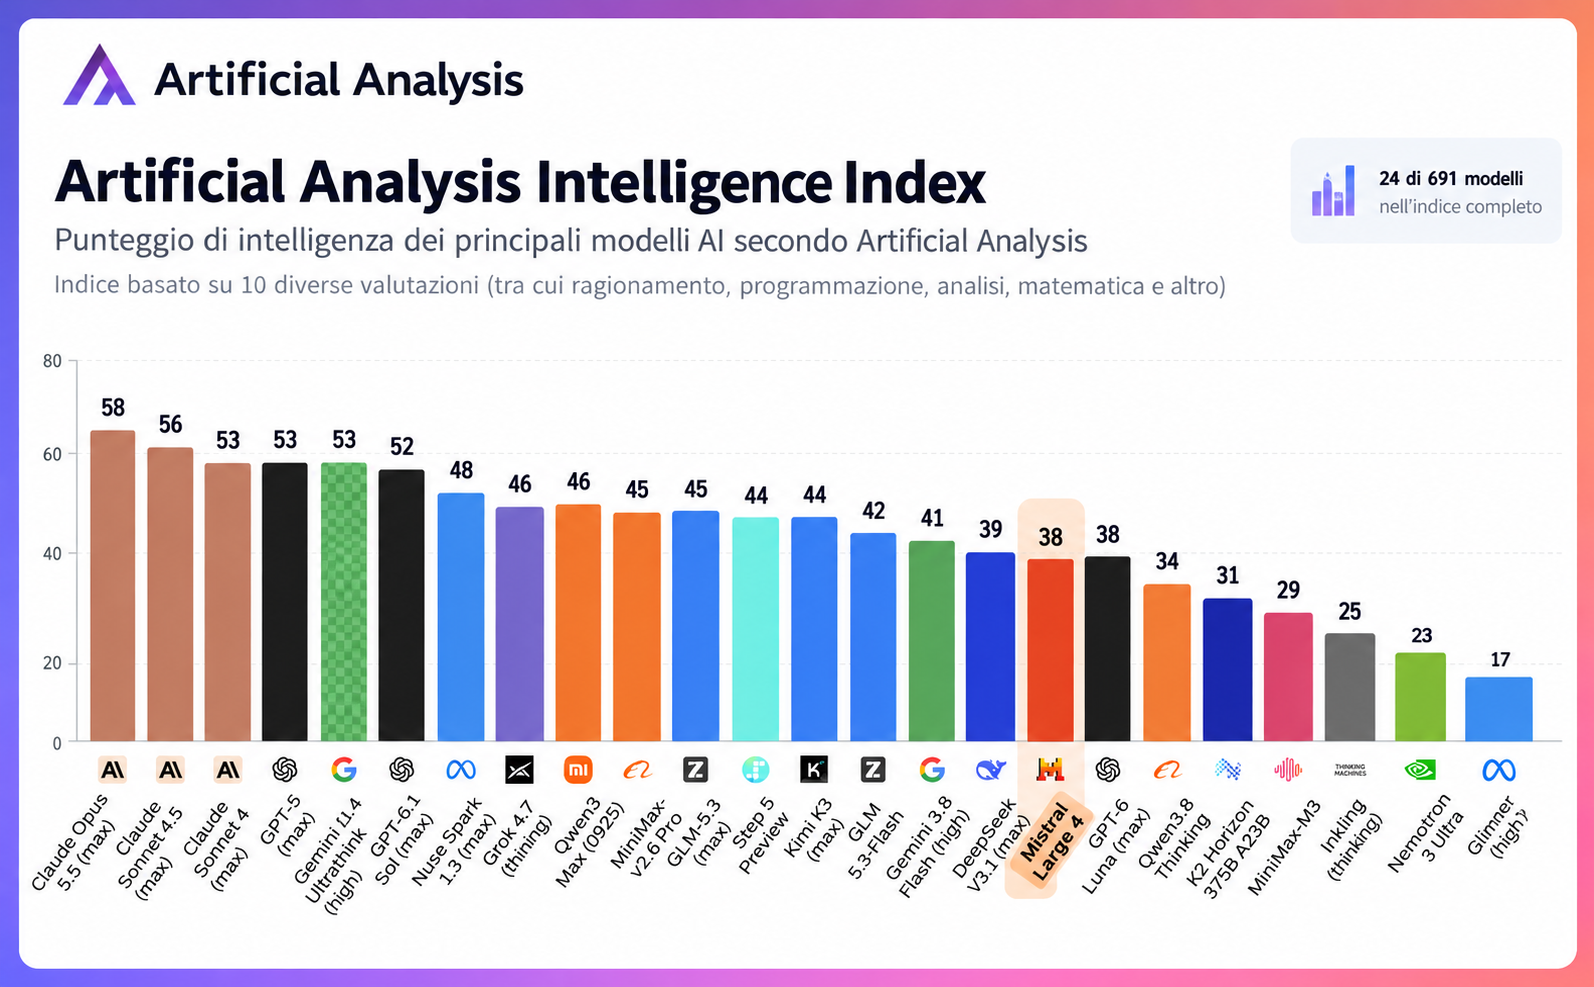
La domanda più interessante dopo il lancio di Grok 4.7 è semplice: quanto è forte rispetto agli altri grandi modelli AI?
La risposta dipende dal benchmark. Grok 4.7 è particolarmente competitivo nel coding, nei lavori agentici e nei compiti professionali, mentre alcuni modelli Claude e GPT rimangono davanti in determinate valutazioni.
Grok 4.7 vs gli altri
Un confronto pubblicato da xAI mette a fianco Grok 4.7, GPT-5.6 Sol e Claude Fable 5.1:
| Benchmark | Grok 4.7 | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|---|
| CursorBench 4.0 | 46,3% | 41,7% | 51,8% |
| DeepSWE v1.1 | 71,0% | 72,7% | 70,0% |
| AA Briefcase | 1.657 | 1.487 | 1.678 |
| Terminal-Bench 4.0 | 38,0% | 37,3% | 57,9% |
| Harvey Legal Agent | 19,6% | 2,5% | 6,7% |
| HealthBench Professional | 56,7% | 60,5% | 62,1% |
| EEBench | 64,0% | 39,4% | 56,4% |
I risultati sono quelli dichiarati da xAI. I benchmark misurano capacità differenti e quindi non possono essere trasformati in un’unica classifica generale.
Coding: Grok 4.7 è competitivo
Nel CursorBench 4.0, Grok 4.7 raggiunge il 46,3%, contro il 41,7% di GPT-5.6 Sol e il 51,8% di Claude Fable 5.1.
Il risultato colloca Grok 4.7 tra i modelli più competitivi per la programmazione, anche se in questo specifico test Claude ottiene un punteggio superiore.
Nel confronto riportato da Cursor:
- Claude Fable 5.1: 51,8%
- Claude Opus 5: 46,6%
- Grok 4.7: 46,3%
- GPT-5.6 Sol: 41,7%
- Gemini 3.8 Flash: 39,6%
Lavoro professionale
Grok 4.7 mostra risultati interessanti anche nei benchmark dedicati a lavori professionali.
Nel benchmark Harvey Legal Agent raggiunge il 19,6%, mentre GPT-5.6 Sol è al 2,5% e Claude Fable 5.1 al 6,7%.
Nell’EEBench, dedicato all’ingegneria elettronica, Grok arriva al 64%, contro il 39,4% di GPT-5.6 Sol e il 56,4% di Fable 5.1.
Questi numeri non significano che Grok sia automaticamente il migliore per legge o ingegneria in generale: indicano i risultati ottenuti in quei benchmark specifici.
E nella LLM Arena?
La Arena misura qualcosa di diverso rispetto ai benchmark tecnici. Gli utenti confrontano le risposte di due modelli e votano quella che preferiscono.
Nello snapshot del 21 settembre 2026, Arena+ riportava:
| Modello | Arena Elo |
|---|---|
| Claude Fable 5.1 | 1.520 |
| GPT-6 Astra | 1.520 |
| Claude Opus 5 | 1.511 |
| Claude Fable 5 | 1.510 |
| GPT-5.6 Sol | 1.509 |
| Grok 4.7 | 1.507 |
| Grok 4.6 | 1.507 |
| Muse Spark 1.3 | 1.507 |
Il dato va letto con attenzione: Grok 4.7 è molto vicino ai modelli di fascia alta, ma l’Arena non misura tutte le capacità di un modello. Inoltre, il punteggio può cambiare nel tempo con nuovi voti e nuovi modelli.
Dove è forte Grok 4.7?
Il profilo che emerge dai benchmark è abbastanza chiaro: Grok 4.7 è pensato soprattutto per lavori lunghi e complessi, coding, utilizzo di strumenti e attività agentiche.
xAI sottolinea anche la capacità del modello di lavorare più a lungo sui problemi, verificare il proprio lavoro e gestire contesti molto estesi.
Il context window arriva a 500.000 token, rendendo il modello adatto anche a grandi quantità di informazioni.
Quanto costa?
Per l’API, xAI indica un prezzo di 2 dollari per un milione di token in input e 6 dollari per un milione di token in output.
Il prezzo è uno degli elementi interessanti del nuovo Grok, soprattutto per chi vuole utilizzare il modello all’interno di applicazioni e agenti AI.
In sintesi
Grok 4.7 non domina ogni benchmark. Claude rimane davanti in diversi test di coding e lavoro professionale, mentre GPT può ottenere risultati superiori in benchmark specifici.
La novità di Grok 4.7 è soprattutto il suo equilibrio tra capacità, lavoro agentico, coding e prezzo.
Con un punteggio Arena+ di 1.507 Elo e risultati molto forti in diversi benchmark specialistici, Grok 4.7 si colloca tra i modelli AI di fascia alta.
Share this content: